

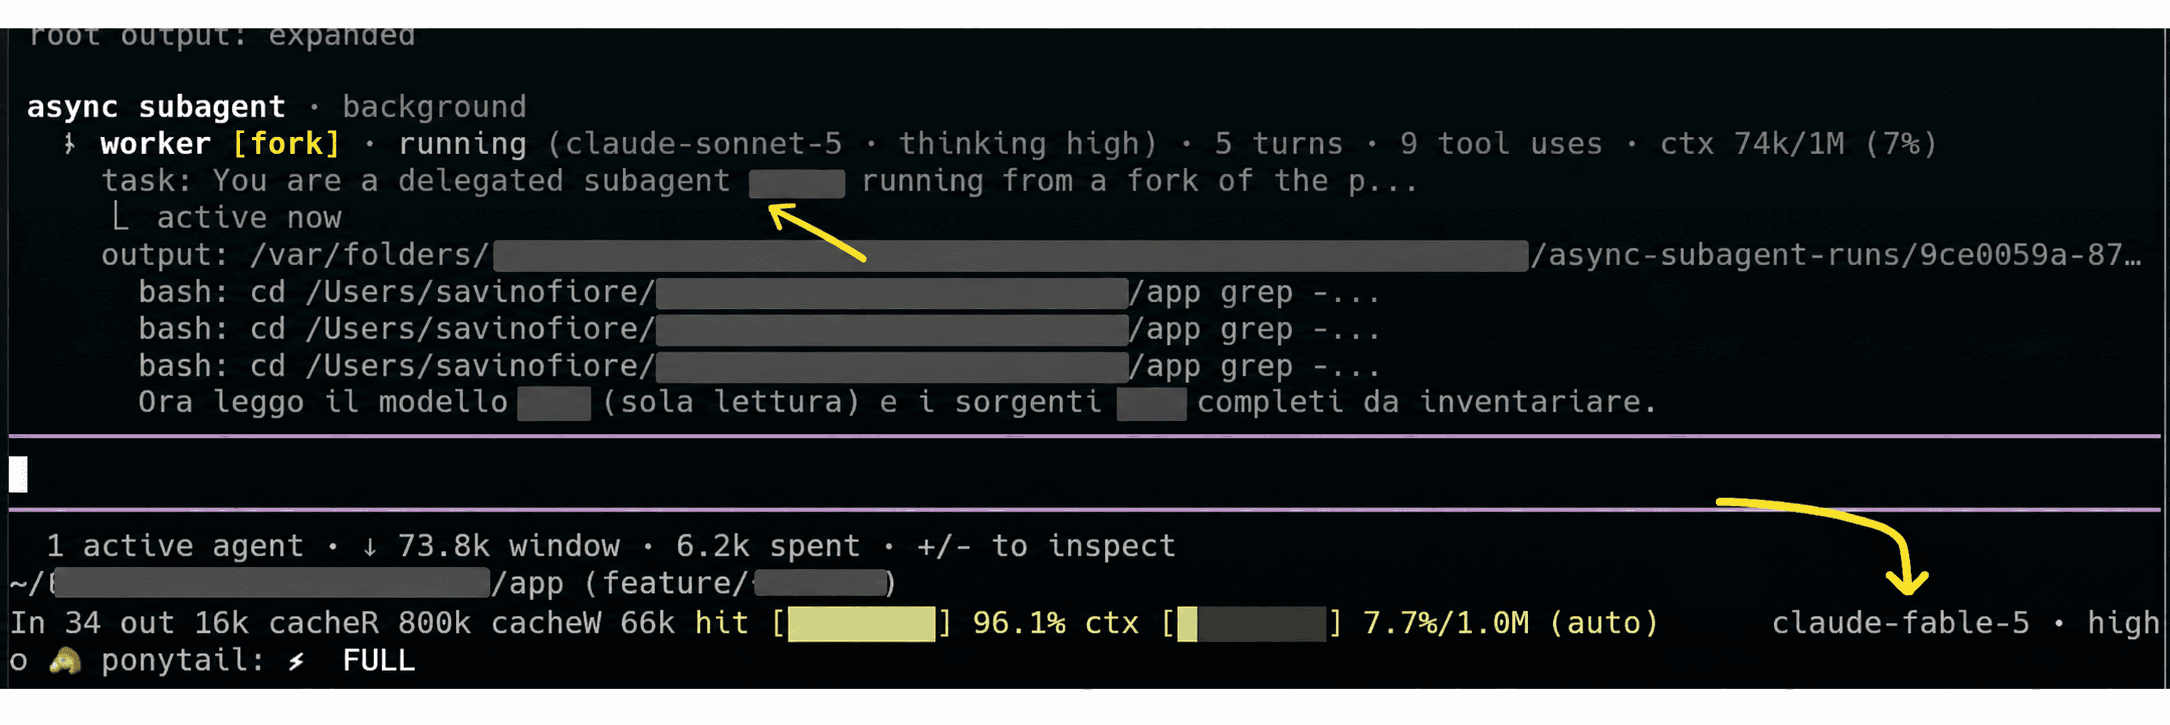
In basso a destra, nella barra della sessione, c'è scritto claude-fable-5 · high. Tre righe più su gira un worker: claude-sonnet-5, thinking alto, cinque turni, nove tool call, una serie di grep dentro il repo dell'app di Finanz.
Il primo decide cosa fare. Il secondo va a leggere. E nessuno dei due sarà l'ultimo a guardare il codice che ne esce.
Sto riscrivendo una grossa fetta dell'app. Su un lavoro di questa taglia, affidarsi a un modello solo è un errore da principiante. Questo è il flusso che uso invece, e il criterio con cui ogni pezzo sta dove sta.
Cinque domande prima di dire «uso Claude»
Sento tutti raccontare come hanno velocizzato lo sviluppo con l'AI. Quasi nessuno sa rispondere a cinque domande:
- quale modello stai usando, e perché proprio quello
- quando ne scegli un altro, e in base a cosa
- chi decide il piano, e chi lo esegue
- quale modello gira sotto ognuno degli agenti
- chi rivede il codice, e se è lo stesso che l'ha scritto
Se la risposta a tutte e cinque è «Claude», non hai un workflow agentico. Hai una chat lunga.
Un workflow agentico, per come lo uso io, è una cosa sola: decidere, eseguire e rivedere sono tre ruoli separati, e ognuno gira sul modello scelto per quel ruolo. Il numero di agenti viene dopo. Prima viene la divisione del lavoro.
Il criterio: intelligenza proporzionata al costo
Non scelgo il modello dalla classifica. Lo scelgo da due cose insieme: quanta intelligenza serve a quel passo, e quanto costa dargliela.
In cima metto Fable 5. È il più capace dei due, ed è anche il più caro. Lo pago dove un errore costa di più: capire cosa va toccato in una riscrittura, spezzare il lavoro in pezzi, decidere cosa delegare e a chi.
Sotto metto Sonnet 5. Leggere il codice, cercare dove vive una logica, inventariare i sorgenti da riscrivere: è volume, non giudizio. Lì serve un modello bilanciato, che regga la mole senza costare come il primo.
Il ragionamento vale nei due sensi. Pagare Fable per fare grep è sproporzionato. Mettere Sonnet a decidere la forma di una riscrittura è risparmiare nel punto sbagliato.
L'orchestratore delega la lettura
Nello screenshot il worker è un fork: parte dal contesto della sessione che lo lancia, quindi sa già cosa si sta facendo. Gira in background, mentre la sessione principale resta libera.
Il suo lavoro è in sola lettura. Le righe di output sono ricerche nel repo, e l'ultima dice che sta per leggere i sorgenti da inventariare, senza modificarli.
È esplorazione: tanta lettura per poche righe utili. Da lì in poi quella lettura resta nel contesto del worker, e all'orchestratore torna il risultato.
È la stessa divisione di prima, vista dal lato del contesto. Il modello caro non si riempie di file che non deve giudicare.
Una persona sola non fa brainstorming
Fin qui è divisione del lavoro. La parte che quasi tutti saltano è la review.
Far rivedere il codice allo stesso modello che l'ha scritto è come fare brainstorming con una persona sola. Può essere brillante, ma le idee che non ha non le trova rileggendosi. Un team con pensieri e ideologie diverse trova quello che il singolo dà per scontato.
Con un modello è peggio, perché il modello non ha dubbi sul proprio lavoro. Per lui il suo codice è perfetto. Rileggerlo nella stessa sessione, o in una nuova con lo stesso modello, lo conferma e basta.
Per questo la review non la fa Claude. La fa Codex.
Codex rivede, Claude giudica la review
Il passaggio è in sequenza, non in parallelo:
- Codex legge il diff e riporta i problemi per gravità, con file e riga. Non tocca un file, perché il suo compito è trovare, non correggere
- Claude rilegge quella review contro il diff vero, finding per finding: lo conferma, lo corregge o lo respinge, con l'evidenza nel codice. Serve a separare i bug dal rumore prima di toccare qualcosa
- Quello che sopravvive ai due passaggi diventa lavoro da fare, e solo quello
I due non si oppongono e non litigano. Si completano. Dove Claude non arriva, arriva Codex, che è un tantino più critico. Dove Codex esagera, Claude lo ferma.
Non conta quale dei due sia il modello migliore. Conta che vengono da due famiglie diverse, e quindi non condividono gli stessi punti ciechi.
Il trade-off: il revisore esagera
Non è un flusso pulito. Codex critica pesantemente il codice di Claude, e trova innumerevoli bug.
Molti non esistono. Altri sono veri ma sproporzionati: un caso limite trattato come un blocco al rilascio. Se applicassi tutto quello che segnala, passerei la riscrittura a correggere problemi immaginari.
Per questo il secondo passaggio non è opzionale. Claude non accetta tutti i finding, e fa bene.
Ma fra quelli che accetta ci sono bug che da solo non avrebbe mai trovato. È il punto dell'intero flusso: il rumore di Codex è il prezzo per vedere quello che Claude non vede.
Resta un limite, e va detto. A giudicare la review è lo stesso modello che ha scritto il codice, quello per cui il suo codice è perfetto. Il rischio che respinga un bug vero per difendere il proprio lavoro non è zero. Il filtro serve contro il rumore, non è una garanzia.
Il principio
Chi scrive il codice non è chi lo rivede. Il modello si sceglie per il ruolo, in proporzione a quanto costa sbagliarlo.
E se ti stai affidando a un solo modello per scrivere e per rivedere, stai pur certo che il tuo codice è rotto. Non in qualche punto. Al 100%.